01 提交材料
先交简历;随后补成绩单、课程项目代码和报告。
RESEARCH PLAN CASEBOOK
下面包含一个完整模拟学员案例和三个脱敏项目案例。其中新增案例使用真实计算机学院导师与真实文献,学生身份脱敏,并公开可编辑 Word、同版 PDF 和技术路线图。
这名学员、目标团队及所有材料均为演示构造,目的是把业务逻辑讲清楚,不把模拟经历冒充陪跑成果。
先交简历;随后补成绩单、课程项目代码和报告。
确认能做什么、证据在哪里、哪些能力仍然缺失。
先形成通用母版;确定导师后再进入定制。
核验研究主线并形成私有匹配矩阵,最后收敛题目。
STEP 1—2
自动化专业大三;已修自动控制原理、信号与系统、Python 程序设计
证据边界:成绩单与课程项目可核对
使用公开轴承数据完成过 CNN 故障分类课程项目
证据边界:有代码与课程报告,但没有跨工况验证
数据清洗、模型训练、混淆矩阵分析与基础实验记录
证据边界:可以支持诊断基线和复现实验
不了解域偏移、PMSM 机理与边缘部署约束
证据边界:不能直接写成已具备相关研究基础
根据现有资产,推荐题目暂定为“面向工况变化的轻量化电机故障诊断稳健性研究”。先写数据划分、跨工况基线、评价与失败处理,不提前绑定某个课题组的项目。
学员补充“某高校电气学院智能运维团队(模拟)”及官方主页。公开调研仅提炼三条模拟主线:PMSM 故障诊断、域泛化稳健性、边缘侧部署;学生私有材料不进入公共导师库。
STEP 3—4
第一行不是“方向很匹配”,而是把导师问题、学生证据、缺口和起步任务逐格连起来。
| 导师近期问题 | 学生已有证据 | 能力缺口 | 30—90 天起步任务 |
| 变工况下的电机故障诊断 | 公开轴承数据分类代码 | 对象从轴承迁移到 PMSM,工况变化尚未处理 | 复现 2 个跨工况基线,固定数据划分并记录失败结果 |
| 域泛化与模型稳健性 | 会训练 CNN 并分析混淆矩阵 | 缺少域划分、外推验证与敏感性分析 | 建立工况留一验证,比较 ERM、归一化与轻量域泛化基线 |
| 边缘侧部署可行性 | 有 Python 推理经验 | 没有延迟、内存和量化测试 | 在普通 CPU 上记录模型大小、延迟与精度变化,不预设硬件结论 |
最终导师讨论版
题目比通用稿更具体,但没有复制导师论文题目。研究从跨工况外推、轻量模型比较和 CPU 推理约束切入;正式设备、现场数据与工程部署仍保持待核实。
文献矩阵、数据字典、工况留一划分与两个基线。
域泛化比较、误差分析、CPU 延迟与模型大小记录。
导师身份、研究方向和代表工作来自公开一手来源;本页不公开学生姓名、联系方式、私有简历或导师接收意愿。
A 股面板数据研修、稳健性与异质性分析、LightGBM/SHAP 入门。
知识图谱、自然语言处理、动态 schema 与专业领域知识增强。
学生尚无系统 NLP、文档级事件抽取和知识图谱训练。
先复现公开金融事件数据,再构建带时间与原文证据的最小图谱。
冻结题目
研究按“公告语料治理—文档级事件抽取—时序事件知识图谱—证据增强风险识别”推进,最终形成风险概率、关键证据路径、跨场景性能比较与误差归因。
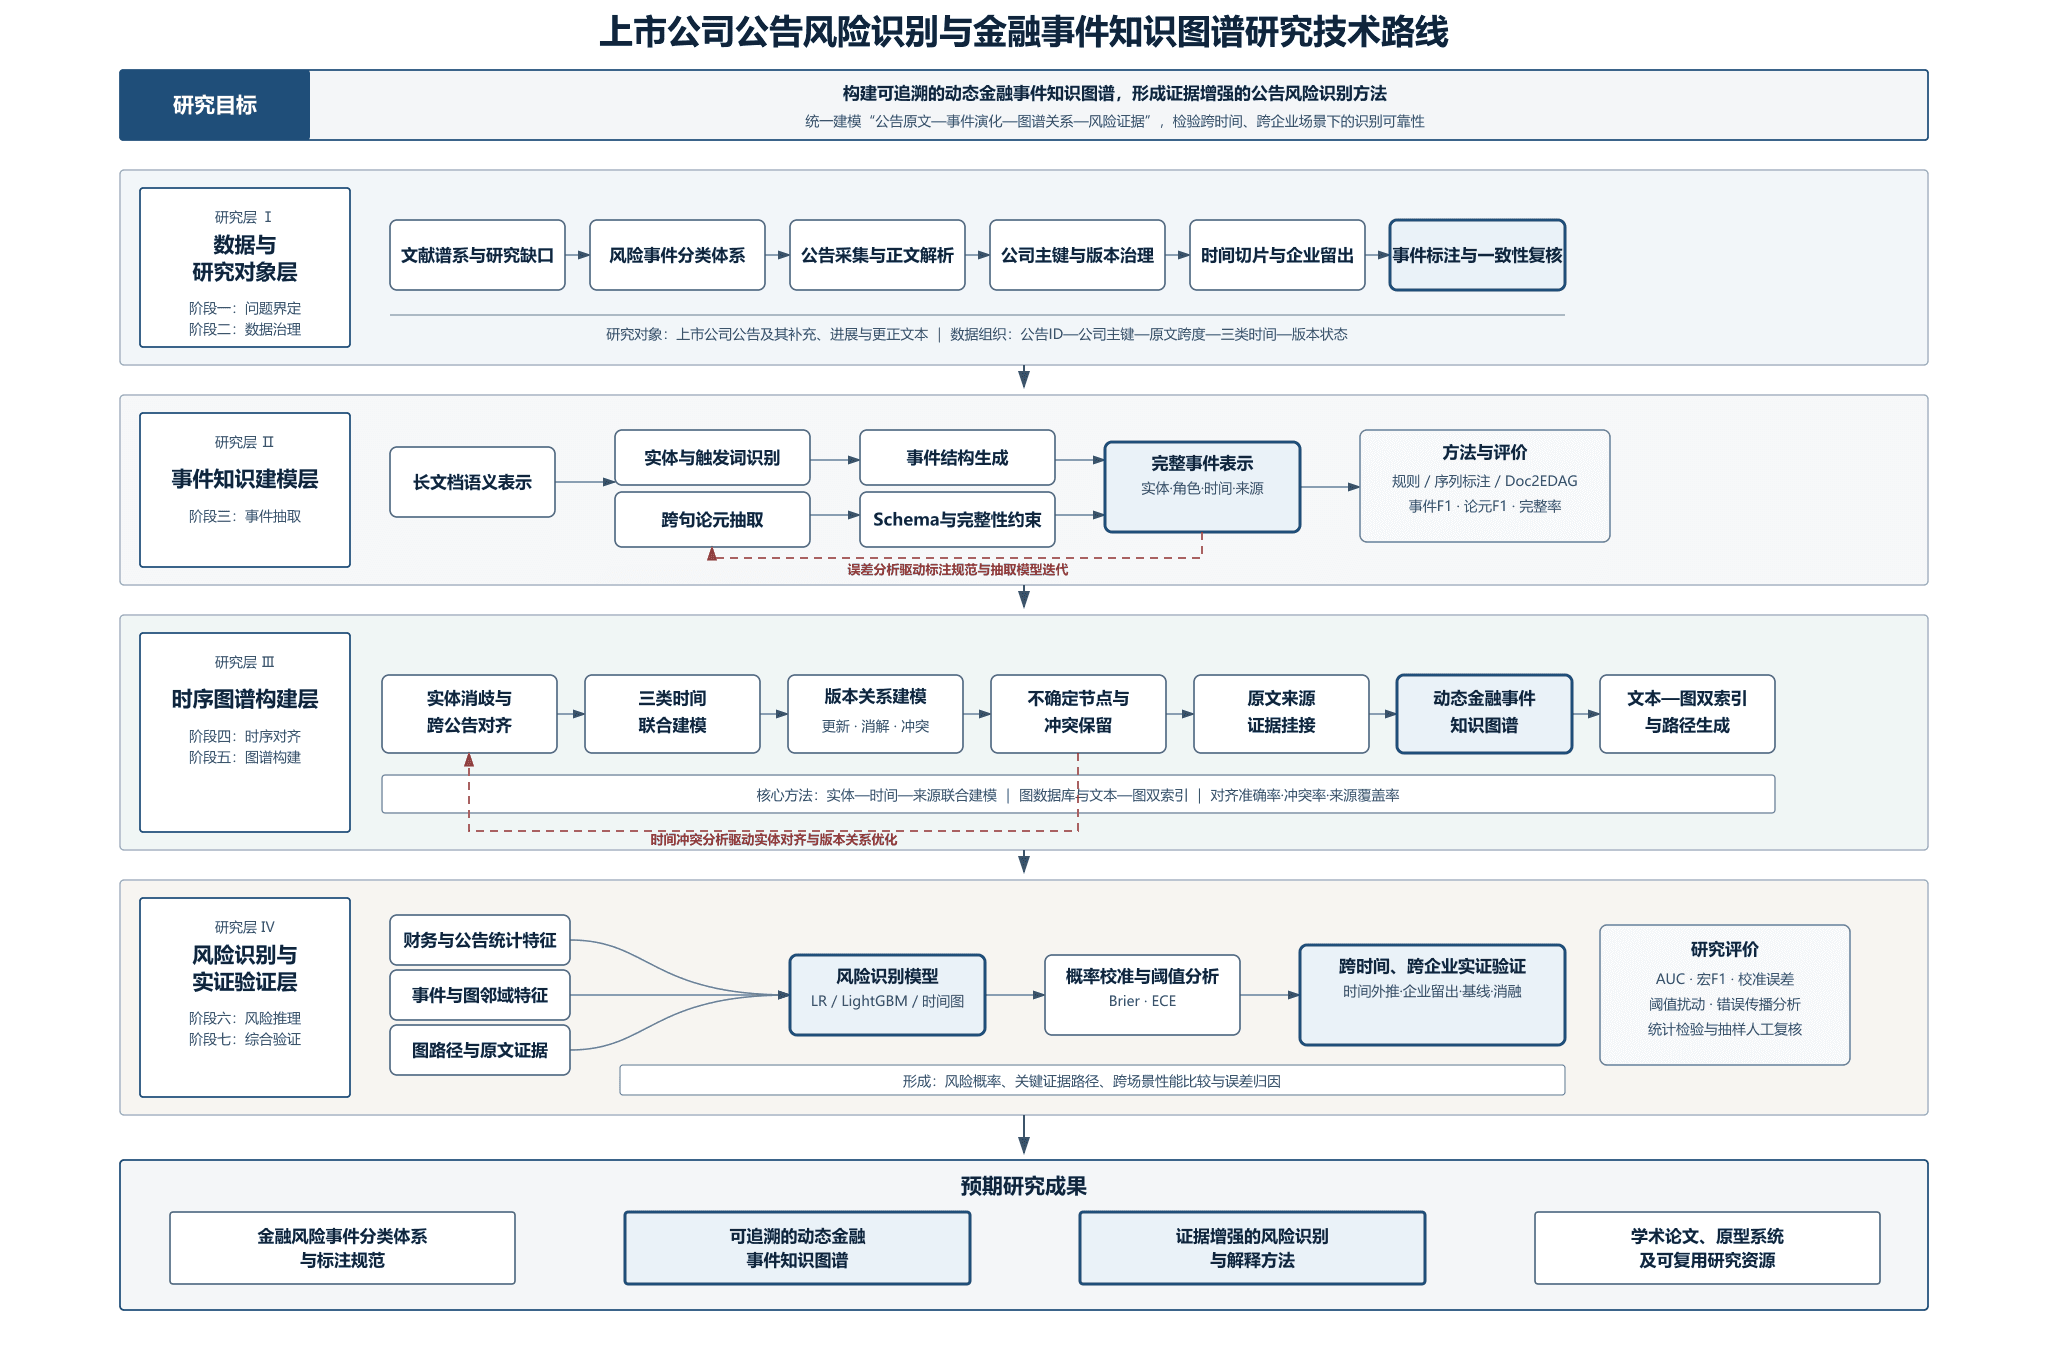
核心文献矩阵、DocFEE 数据字典、一个透明事件抽取基线。
文档级模型复现、按文档长度与事件类型分层的误差分析。
带公告 ID、原文跨度、时间状态和版本信息的最小事件图谱。
原案例来自数字经济背景学员:已有计量经济学、面板数据和机器学习/SHAP 项目经验;目标导师公开主线涉及低碳出行、MaaS 方案选择与交通方式识别。公开页只保留这一适配逻辑。
计量与 ML 经历可迁移到异质性、稳健性和可解释建模。
行为理论、离散选择模型和数据驱动交通分析。
不是缺一个新模型,而是政策结论在样本与模型扰动下是否稳定。
先做文献矩阵、数据字典和公开数据复现;真实个体数据需另行许可。
正文中的四个问题
样本结构、缺失机制与观测误差会怎样改变低碳激励和套餐属性的估计结果?
不同收入、家庭生命周期、既有习惯与低碳态度群体的选择偏好有何差异?
离散选择模型与 LightGBM/SHAP 对关键因素的方向、重要度和交互能否相互印证?
价格、碳积分与公共交通权益变化时,哪些建议对数据扰动和模型设定最不敏感?
这个案例的价值不是“写了 27 页”,而是把原先按技术名词堆叠的小论文式设想,重构为立项依据、问题分解、数据证据阶梯、验证和研究基础连续闭环。
说明城市更新、低空交通需求与设施布局之间的现实矛盾,不把政策热词当作科学问题。
把需求识别、候选点生成、约束建模、布局优化和多情景评估拆成可验证内容。
区分公开代理数据、规划数据、运营数据和现场数据;不同层级只支持对应强度的结论。
公开数据只验证 GIS 处理、候选点筛选和优化流程可运行,不冒充工程选址结论。
比较基线、权重敏感性、约束变化和跨情景稳定性;数据不足时收窄到方法演示。
形成研究内容、技术路线、证据矩阵、图表、参考文献与阶段计划的基金式长版。
不能越过的边界:公开 POI、路网或人口栅格只能支持方法链和候选情景演示;没有正式空域、运营、审批与现场约束时,不能声称完成真实城市设施选址或工程规划。
看完案例后
只有简历也可以开始。先完成资产初评,再决定通用型或导师定制型;不会要求学员在不了解研究方向时先编题目。